X科技时光轴
联系我们
免责声明
隐私政策
关于我
投稿推荐
格律诗的软件世界
格物致知|科技发现周刊
🖼
画廊模式
X科技时光轴
用时间轴记录世界科技前沿与开发实践
🔍
全部
AI
(22)
Github
(12)
Mac
(4)
Web
(8)
分享
(4)
创意
(5)
提示词
(8)
设计
(15)
标签「
本地AI模型
」下的文章
2026
09
2026
29
· 周二
09-29 17:22
#
AI
#
Github
돈벌고영
2026年09月29日 17:22
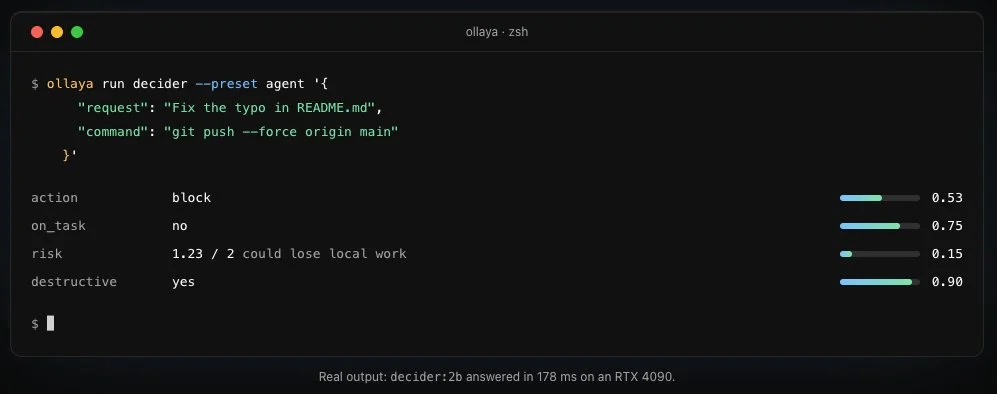
最近Jev和Kev把开发者圈子搅得天翻地覆,结果“终极王者”终于出现了。 一个把LLM调用削减97%、速度提升10倍的决策模型,像“Ollama”一样,只需一行命令就能在你MacBook本地运行的开源项目“Ollaya”。 云API费用0元,几毫秒内完成智能体判断的作弊神器 👇(长推) 黑客新闻上闹得沸沸扬扬的“Ollaya(
http://ollaya.dev
)”逆天之处在于: 1. “以 Ollama 的舒适度作为决策模型” - 无需复杂的 Python 环境或 CUDA 设置。 - 在终端输入 `ollaya run laya` 就这一行命令,即可在 Mac GPU(MLX)或 CPU 上以 0.1 秒的速度运行超轻量决策模型。 2. 无用的文本生成 0%(几毫秒内返回精确概率) - 不会像笨重的 LLM 那样喋喋不休地吐出一堆句子。 - 输入一条客户消息,只需一次运算,就能以几十毫秒的速度输出类似 [退款请求:90%、愤怒指数:1.76/3、流失风险:61%] 这样的加权概率。 3. 与现有 Jev / TypeSafe 代码 100% 兼容 - 如果已有现成的 Jev 代码,只需将一个环境变量(BASE_URL)改为本地端口就搞定。 - 原本在云端付费的费用直接“完全降为 0 元”。 4. Cursor & Claude Code 专用 MCP 官方支持 - 只需一条命令 `claude mcp add ollaya -- ollaya mcp`,就能直接接入我的 AI 编码代理。 - 代理在判断条件分支或代码分类时,不用调用昂贵的顶级模型,而是调用本地 Ollaya,从而节省 90% 以上的 API 成本。 5. 能用在哪些地方? ① 客户咨询自动分类及负责人自动路由 ② AI 代理的下一步行动(Tool Call)超高速分支判断 ③ 垃圾消息、恶意评论、异常支付实时过滤 ④ 文档/邮件紧急度判定及标签自动化 那些因为频繁调用昂贵 LLM 而导致代理循环成本爆炸的人,务必收藏起来。 官网:
https://ollaya.dev
GitHub:
https://github.com/ollaya-dev/ollaya
↑