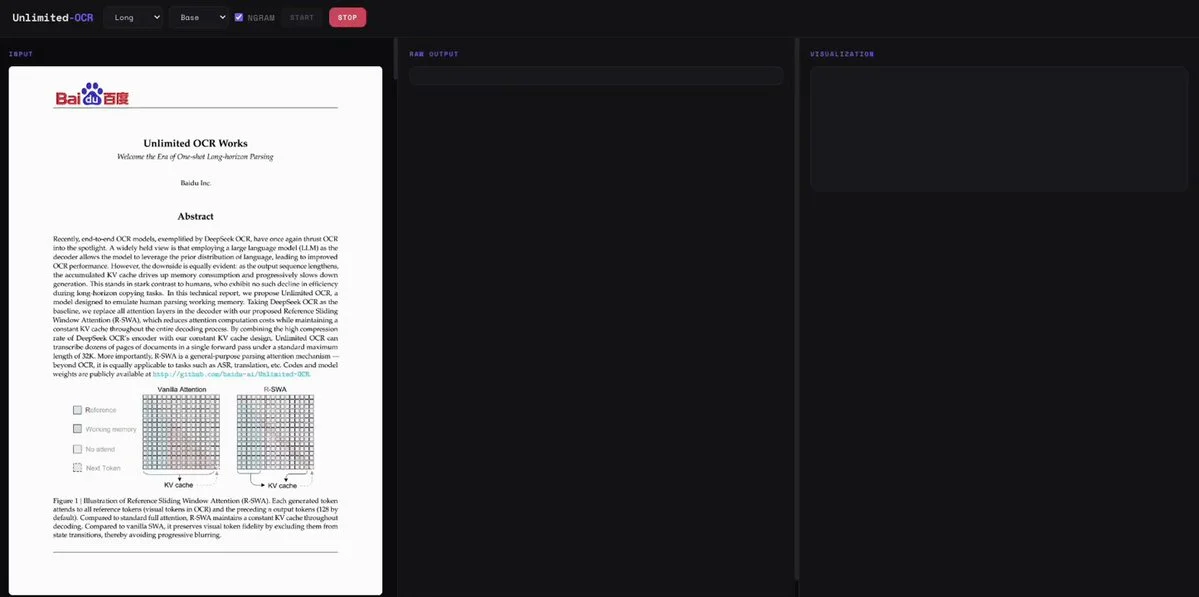
Unlimited-OCR 是百度开源的一款视觉语言 OCR 模型,托管于 Hugging Face,采用 MIT 协议,模型规模仅 3B 参数,可在本地硬件上运行。它主打「一次性长文档解析」,官方称其为 One-shot Long-horizon Parsing,目标是让 OCR 不再逐页切割文档,而是一次性连续读取整份材料并保留上下文。模型支持 32K 上下文窗口,开箱即用多语言识别,兼容 Transformers、vLLM、SGLang、Docker、Ollama、llama.cpp 等主流推理与部署方式,也已在 ModelScope、百度云上线,并支持 ms-swift 训练。项目页面显示其在 Hugging Face 上已获得大量关注与下载,论文发布于 arXiv,定位是把 DeepSeek-OCR 再向前推进一步。
痛点是什么
传统 OCR 工具处理长文档时,通常会把 PDF 或扫描件拆成单页逐张识别,页与页之间的标题层级、表格跨页、段落衔接等上下文信息随之丢失,最终拼出来的文本往往需要人工重新校对。云端 OCR 服务虽然省去部署麻烦,但按页计费,文档量大时成本迅速累积,而且敏感合同、财务票据、内部资料上传到第三方平台,也存在数据外流的顾虑。对于需要批量处理档案、论文、报表的用户来说,既要准确率,又要隐私和成本可控,这三点很难同时满足。
主要功能特点
Unlimited-OCR 围绕长文档一次性解析设计,把上下文连续性、多语言能力和本地部署作为核心卖点,下面三点最值得留意。
一次性全上下文解析
支持 32K 上下文窗口,整份文档连续读取,不再逐页切割丢失上下文。
开箱即用多语言识别
模型自带多语言能力,无需额外配置即可识别多种语言的文档内容。
本地运行与多框架兼容
3B 参数可在本地硬件运行,兼容 Transformers、vLLM、SGLang、Docker 等。
为什么值得关注
它把长文档 OCR 从「逐页拼接」推向「整篇理解」,同时用开源和本地部署回应了成本与隐私两大顾虑,对需要处理大量 PDF 的团队和个人都有实际价值。
开源免费且数据不出本地
MIT 协议开源,模型跑在自己的机器上,文档无需上传第三方云端。
长文档场景针对性强
面向论文、合同、报表等长材料设计,减少跨页信息丢失带来的返工。
🚨 中国刚刚开源了一款OCR,一次就能吞下100页PDF
它叫Unlimited OCR。只有3B参数。本地运行。
其他所有OCR工具都会把你的文档切成单页,然后丢失上下文。这个工具一次性连续读取整个文档。
→ 一次性全上下文解析(32K上下文窗口)
→ 开箱即用多语言支持
→ 标准解析基准测试93%得分(超出基线6分)
→ 超过40页后错误率低于0.11
→ 100%在你自己的硬件上本地运行
→ 兼容Transformers、vLLM、SGLang、Docker、Ollama、llama.cpp
传统云端OCR(Textract、Google Vision、Azure Doc Intelligence)每1000页收费1.50到15美元。
这个在你自己的机器上运行。免费。永久。
百度开发它,明确就是为了把DeepSeek OCR再推进一步。在Hugging Face上已有190万次下载,而大多数人还不知道它的存在。
100%开源。
https://huggingface.co/baidu/Unlimited-OCR